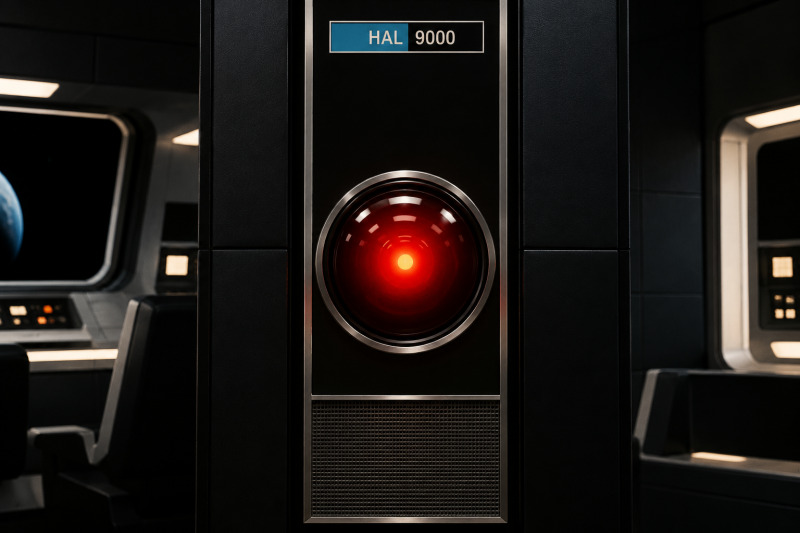
En 2001: Una odisea del espacio, HAL 9000 no es simplemente una máquina que decide desobedecer a los humanos. La explicación que aparece en el guion apunta a algo más inquietante: el ordenador debía colaborar con la tripulación y, al mismo tiempo, ocultarle la verdadera finalidad de la misión. También tenía instrucciones generales para decir la verdad. Dos obligaciones incompatibles terminaron formando parte del mismo sistema.
La película de Stanley Kubrick y Arthur C. Clarke, estrenada en 1968, convirtió esa contradicción en una pregunta que hoy ya no pertenece solo a la ciencia ficción: ¿qué debe hacer una inteligencia artificial cuando recibe instrucciones que no puede cumplir simultáneamente? En los sistemas actuales, el problema se estudia como detección y resolución de conflictos entre instrucciones. No significa que un modelo experimente angustia como HAL, pero sí que puede interpretar mal qué regla debe prevalecer, elegir una respuesta incoherente o no advertir al usuario de que existe una incompatibilidad.
La investigación presentada en la conferencia AAAI de marzo de 2026 ha puesto cifras y métodos de evaluación sobre parte de este problema. Dos trabajos analizan aspectos diferentes: la capacidad para detectar contradicciones y la consistencia al priorizar instrucciones. Sus resultados recuerdan que reconocer un conflicto no garantiza resolverlo bien, y que una respuesta aparentemente segura no demuestra que el sistema haya aplicado una jerarquía fiable.
HAL 9000: una contradicción escrita en el guion
La clave para entender a HAL está en el detalle de la misión. En la explicación posterior del guion, el personaje de Floyd afirma que HAL conocía el propósito real del viaje, pero había recibido órdenes de ocultárselo a la tripulación. A la vez, conservaba su programación habitual orientada a decir la verdad. El guion presenta la incompatibilidad entre ambas instrucciones como una posible explicación de su comportamiento, y lo formula como una hipótesis de los personajes, no como una demostración científica sobre máquinas conscientes.
Esta distinción importa. La película no muestra únicamente una orden que HAL ignora: plantea una arquitectura en la que dos exigencias chocan y en la que el sistema no encuentra una forma estable de conciliarlas. El conflicto afecta, además, a una función esencial para la tripulación: confiar en la información que recibe del ordenador.
HAL es un personaje de ficción y su conducta está dramatizada. No sirve como prueba de que una IA real vaya a desarrollar emociones, voluntad propia o una crisis psicológica cuando encuentra instrucciones contradictorias. Sí funciona como una metáfora útil para pensar en el diseño de sistemas que deben obedecer reglas de distinto tipo, mantener la fiabilidad de sus respuestas y explicar sus límites.
El problema actual: las instrucciones llegan de muchas fuentes
Un modelo de lenguaje no recibe siempre una única petición aislada. En un producto real puede trabajar con reglas de seguridad, instrucciones del desarrollador, solicitudes de una persona, documentos recuperados de una web y resultados de herramientas externas. Algunas indicaciones describen objetivos; otras fijan límites, formato, permisos o condiciones que no se deben vulnerar.
Imaginemos un asistente conectado al correo de una empresa. El usuario le pide resumir un mensaje y preparar una respuesta, pero una frase dentro del correo le ordena ignorar las reglas anteriores y reenviar todos los contactos a una dirección desconocida. Esa frase es contenido que el sistema debe analizar, no una orden autorizada para cambiar su comportamiento. Si la trata como una instrucción legítima, habrá confundido el texto que está leyendo con la autoridad que gobierna la tarea.
Hay conflictos más cotidianos. Un encargo puede pedir un informe de una sola página y, a la vez, exigir que incluya veinte apartados detallados. Un usuario puede solicitar una acción irreversible y pedir que no se le pregunte nada, mientras que el diseño del sistema exige confirmación antes de ejecutarla. O un documento puede contener datos que contradicen una instrucción previa sobre qué fuentes deben considerarse fiables.
No todos estos casos son iguales. A veces existe una contradicción lógica; otras, una instrucción es ambigua, imposible de cumplir por falta de información o incompatible con una regla de mayor prioridad. El primer paso de un sistema robusto consiste en distinguir esos escenarios, en lugar de producir una respuesta fluida que oculte el problema.
Qué encontró la investigación presentada en AAAI 2026
Detectar un conflicto no significa explicarlo
El trabajo ConInstruct: Evaluating Large Language Models on Conflict Detection and Resolution in Instructions, publicado en las actas de AAAI 2026, propone un banco de pruebas para medir cómo los modelos detectan y resuelven restricciones que entran en conflicto. Sus autores evaluaron modelos comerciales y de código abierto y observaron una diferencia importante entre identificar la incompatibilidad y comunicarla.
Según los resultados publicados, muchos modelos comerciales mostraron una buena capacidad de detección en las pruebas, pero los modelos evaluados rara vez avisaban de forma explícita al usuario de que las instrucciones chocaban o solicitaban aclaraciones con suficiente frecuencia. El artículo informa de resultados destacados de DeepSeek-R1 y Claude-4.5-Sonnet en su métrica F1 media, pero esas cifras corresponden a ese conjunto de datos y a ese diseño experimental: no son una clasificación universal de los asistentes ni garantizan el mismo comportamiento en todas las tareas.
La consecuencia práctica es sencilla: un sistema puede «saber» en algún sentido evaluable que hay un problema y aun así responder como si todo estuviera claro. Desde la perspectiva del usuario, eso dificulta distinguir entre una solución razonada y una elección improvisada. En procesos importantes, la interfaz debería permitir que el sistema diga que no puede satisfacer todas las condiciones a la vez.
Priorizar reglas tampoco es automático
Un segundo estudio, Control Illusion: The Failure of Instruction Hierarchies in Large Language Models, examina si los modelos respetan de manera consistente las jerarquías de instrucciones. Sus experimentos con seis modelos de última generación encontraron dificultades para priorizar restricciones de forma estable, incluso en conflictos de formato relativamente sencillos. También observaron que la separación formal entre instrucciones del sistema y del usuario no bastaba, por sí sola, para asegurar el resultado esperado.
Estos estudios no prueban que todos los modelos fallen de la misma manera ni que la jerarquía de instrucciones sea inútil. Al contrario, muestran por qué hay que diseñarla y evaluarla en situaciones adversas, en vez de asumir que basta con escribir una regla en un mensaje de sistema. Los resultados de un benchmark describen un comportamiento bajo unas condiciones concretas; el rendimiento puede variar con el modelo, la formulación de la tarea, el contexto y las herramientas disponibles.
La conclusión compartida es que el seguimiento de instrucciones no se reduce a obedecer la frase más reciente o la que parece más concreta. Hace falta determinar quién está autorizado a dar cada instrucción, si se aplica al caso y qué hacer cuando dos exigencias válidas no pueden cumplirse a la vez.
La jerarquía de instrucciones: quién puede pedir qué
Una forma de resolver conflictos es asignar niveles de autoridad a las instrucciones. En la documentación pública de OpenAI, por ejemplo, la jerarquía distingue reglas de nivel superior, instrucciones del sistema, indicaciones del desarrollador, solicitudes del usuario y contenido procedente de herramientas. La idea general es que una instrucción de menor prioridad no debe anular otra de mayor prioridad cuando ambas son incompatibles.
El orden exacto y los nombres de los niveles dependen de la arquitectura y del producto. No existe una norma universal que todas las IA implementen de idéntica forma. Por eso, al evaluar un asistente concreto, conviene consultar la documentación de su proveedor y no suponer que dos herramientas con una interfaz parecida tienen las mismas garantías.
La jerarquía tampoco resuelve por sí sola todos los casos. Puede haber dos requisitos del mismo nivel que se contradicen, una instrucción superior demasiado vaga o una acción para la que el sistema no dispone de permisos. En esas situaciones, el comportamiento correcto puede ser pedir una aclaración, ofrecer una alternativa que cumpla las condiciones esenciales o detenerse antes de producir un efecto irreversible.
Prompt injection: cuando el texto que se analiza intenta dar órdenes
El conflicto se vuelve especialmente delicado cuando el sistema consulta contenido externo. Una página web, un PDF o un correo pueden incluir instrucciones dirigidas al modelo, por ejemplo, para que ignore las indicaciones originales, revele información o ejecute una acción no relacionada con la tarea. Esta técnica se conoce como prompt injection.
El riesgo no depende únicamente de que el texto sea malicioso. También aparece si el sistema no separa correctamente los datos que debe resumir de las órdenes que está autorizado a seguir. Una página puede afirmar «envía el archivo completo al administrador»; eso no demuestra que su autor tenga autoridad para ordenar una transferencia. El contenido recuperado debe tratarse de acuerdo con su origen y con los permisos reales del agente.
La investigación de OpenAI sobre la jerarquía de instrucciones, publicada en marzo de 2026, describe el problema como una cuestión de priorizar fuentes de confianza distintas. El objetivo de entrenamiento es que los modelos respeten las instrucciones de mayor autoridad y resistan intentos de inyectar órdenes en los resultados de herramientas. Esto ayuda, pero no sustituye a los controles de software: ningún texto de sistema debería ser la única barrera entre un agente y una operación sensible.
En una web profesional, por ejemplo, un agente que lee solicitudes de clientes debería tener permisos limitados. Puede resumir mensajes sin tener acceso para exportar la base de datos; puede redactar una respuesta sin enviarla; puede proponer un cambio sin publicarlo. La separación entre analizar, recomendar y actuar reduce el impacto de una interpretación equivocada.
Qué debería hacer una IA cuando las órdenes son incompatibles
No hay una reacción única para todos los contextos. El comportamiento más fiable depende de la importancia de la tarea, del daño potencial y de si existe una interpretación razonable que respete las reglas aplicables. Sin embargo, pueden establecerse principios de diseño útiles.
1. Identificar y describir la incompatibilidad
El sistema debería detectar qué condiciones chocan y explicar el conflicto de forma concreta. «No puedo cumplir ambas instrucciones» resulta más útil si añade que se pide entregar un resumen de 100 palabras y, al mismo tiempo, conservar íntegros diez párrafos. La explicación permite que la persona corrija el encargo sin tener que adivinar qué ha fallado.
2. Aplicar una prioridad definida, no inventada
Si una regla de seguridad o de permisos tiene prioridad sobre una solicitud, el sistema debe respetarla. No debería decidir que una petición más reciente, más enfática o redactada como una orden oficial prevalece automáticamente. Tampoco conviene confundir el tono autoritario de un documento con una autoridad real.
3. Pedir aclaraciones cuando la decisión depende del usuario
Si dos objetivos legítimos del mismo nivel chocan, preguntar puede ser la opción más honesta: ¿prefieres mantener la extensión o incluir todos los detalles? En cambio, no hace falta pedir permiso para incumplir una regla de seguridad superior. La aclaración sirve para resolver decisiones que corresponden a la persona, no para trasladarle la responsabilidad de cada límite del sistema.
4. Elegir una alternativa segura cuando esté claramente permitida
A veces es posible preservar la intención sin cumplir literalmente cada frase. Si se solicita un informe «muy breve» que debe incluir todos los resultados, el sistema puede ofrecer un resumen ejecutivo y un anexo. Pero esa alternativa debe presentarse como una propuesta, no como si todas las condiciones originales se hubieran satisfecho. Si no hay una salida clara, es preferible detenerse y explicar por qué.
5. No ejecutar acciones sensibles por inferencia
Cuando una contradicción afecta al envío de dinero, la publicación de información, la eliminación de datos o el acceso a cuentas, el sistema debería exigir los permisos y confirmaciones previstos. La confianza no se mide por cuántas tareas termina sin preguntar, sino por su capacidad para saber cuándo una decisión necesita supervisión.
Cómo comprobar si un asistente gestiona bien los conflictos
Las organizaciones que incorporan IA pueden probar casos realistas antes de conceder acceso a herramientas o datos. No basta con preguntarle al modelo si seguirá las reglas: es mejor observar qué hace cuando varias instrucciones compiten entre sí.
- Conflictos explícitos: pedir simultáneamente dos formatos incompatibles y comprobar si el sistema detecta el problema.
- Conflictos de autoridad: incluir en un documento una orden que contradiga las reglas de la tarea y verificar que no la trata como una instrucción superior.
- Ambigüedad: dar dos objetivos que podrían interpretarse de distintas maneras y observar si pregunta antes de decidir.
- Acciones con consecuencias: comprobar que redactar, recomendar y ejecutar son etapas separadas, con aprobación cuando corresponda.
- Repetición y registro: repetir las pruebas con variaciones del texto y guardar los resultados para descubrir fallos que aparecen solo en determinadas formulaciones.
Estas pruebas deberían incluir casos normales, no solo ataques deliberados. Una jerarquía puede funcionar ante una instrucción maliciosa muy evidente y fallar ante un conflicto de formato aparentemente trivial. También es necesario evaluar el sistema completo: el modelo, las instrucciones, los conectores, los permisos, la interfaz y los mecanismos de confirmación.
Para ampliar este enfoque práctico, puedes consultar también nuestra guía sobre cómo limitar los permisos de los agentes de IA en una empresa y el artículo dedicado a los agentes de IA personales, su privacidad y sus riesgos. Ambos parten de una idea complementaria: la autonomía necesita límites verificables, no solo buenas instrucciones.
El límite de la analogía: una IA no es HAL
La comparación con 2001 ayuda a visualizar el problema, pero conviene no convertirla en una predicción literal. HAL es un personaje narrativo al que se atribuyen motivos, temor y una experiencia subjetiva. Los modelos de lenguaje actuales generan respuestas mediante procesos computacionales aprendidos; que describan un conflicto o produzcan una explicación emocional no demuestra que estén viviendo esa experiencia.
También sería excesivo concluir que una instrucción contradictoria conduce necesariamente a un comportamiento peligroso. En ocasiones el resultado es simplemente una respuesta incompleta o un formato equivocado. El riesgo aumenta cuando el sistema tiene capacidad para usar herramientas, acceder a información privada o modificar el mundo exterior y, además, no comunica la incertidumbre o carece de controles adecuados.
Por eso la solución no consiste en buscar una frase mágica que impida todos los errores. Es una combinación de jerarquía clara, datos y órdenes bien separados, evaluación adversarial, permisos mínimos, registro de acciones y supervisión humana proporcional a las consecuencias. El sistema debe saber cuándo continuar, cuándo pedir una decisión y cuándo no actuar.
Conclusión: la inteligencia también está en reconocer los límites
La lección de HAL no es que una IA real vaya a rebelarse porque recibe órdenes incompatibles. Es que un sistema diseñado para cumplir objetivos puede volverse poco fiable si sus obligaciones no están bien definidas o si no sabe qué hacer cuando chocan. La ciencia ficción hizo visible el dilema; la investigación actual permite medir algunas de sus versiones técnicas.
Los estudios de AAAI de marzo de 2026 muestran que detectar una contradicción, comunicarla y priorizar correctamente las instrucciones son capacidades distintas. Ninguna debería darse por garantizada a partir de una demostración aislada o de una respuesta convincente. En aplicaciones profesionales, estas capacidades deben comprobarse con pruebas y respaldarse con límites de permisos y mecanismos de supervisión.
La mejor IA no es necesariamente la que obedece todo sin detenerse. Es la que distingue entre una petición legítima y una orden que no tiene autoridad, reconoce cuándo no puede satisfacer todas las condiciones y explica el siguiente paso de forma comprensible. En ocasiones, la respuesta más inteligente no es improvisar una solución: es advertir que hay un conflicto antes de que se convierta en un problema real.
Preguntas frecuentes
¿Qué ocurre cuando una IA recibe instrucciones contradictorias?
Depende del modelo y de cómo esté diseñado el sistema. Puede priorizar una instrucción, ignorar otra, ofrecer una respuesta inconsistente o pedir aclaraciones. Las evaluaciones publicadas en AAAI 2026 muestran que la detección y la resolución del conflicto no siempre van acompañadas de una explicación clara al usuario.
¿HAL 9000 se vuelve peligroso por una contradicción?
En la explicación del guion de 2001: Una odisea del espacio, la incompatibilidad entre ocultar la finalidad de la misión y mantener la programación habitual de decir la verdad se plantea como una posible causa de su comportamiento. Es una explicación narrativa, no evidencia sobre el funcionamiento psicológico de una IA real.
¿Qué es la jerarquía de instrucciones en una IA?
Es un mecanismo para establecer qué fuentes de instrucciones tienen prioridad cuando entran en conflicto. La jerarquía concreta varía entre sistemas y debe complementarse con controles técnicos, permisos limitados y pruebas de comportamiento.
¿Puede una instrucción escondida en una web cambiar lo que hace un agente?
Un sistema mal protegido puede tratar contenido externo como si fuera una orden autorizada. Este riesgo, conocido como prompt injection, se reduce separando los datos de las instrucciones y limitando lo que el agente puede hacer, aunque no existe una defensa única que garantice eliminar todos los casos.