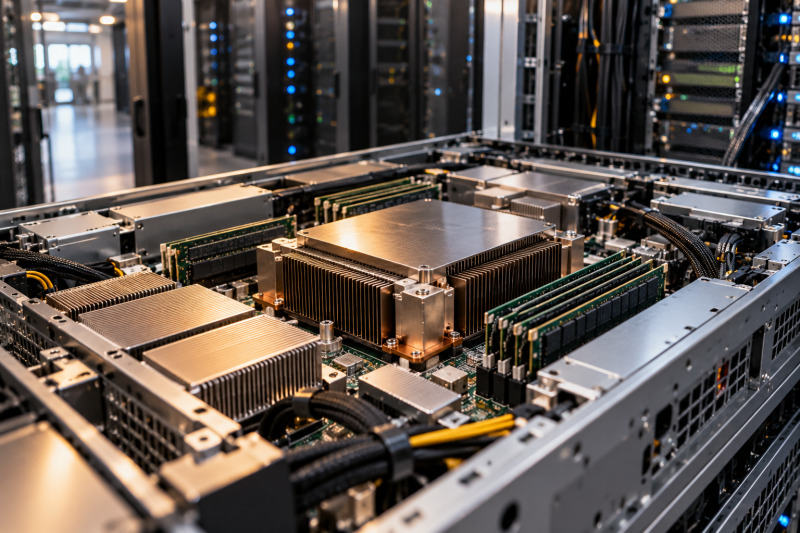
La próxima mejora visible de una inteligencia artificial no siempre empieza en el modelo que conversa con el usuario. A veces comienza mucho antes, en los centros de datos que lo ejecutan: en los procesadores, la memoria, la red que conecta los servidores y la energía necesaria para mantener todo funcionando. Esa parte menos vistosa se ha convertido en una de las áreas estratégicas de la industria.
Microsoft lleva varios años diseñando aceleradores propios para Azure y, el 12 de octubre de 2026, anunció que ampliará su familia Maia hacia despliegues de escala multigigavatio a partir de 2027, según el comunicado oficial de la compañía. La compañía quiere que sus chips tengan un papel central en la inferencia de IA de sus productos y servicios. No significa que vaya a abandonar a NVIDIA ni que fabricar silicio propio garantice automáticamente una ventaja: significa que busca más control sobre el coste, la capacidad y el rendimiento de una infraestructura que cada vez exige más recursos.
El interés de esta estrategia va más allá de una competición entre fabricantes. Ayuda a entender por qué las grandes plataformas tecnológicas están desarrollando sus propios procesadores y qué consecuencias puede tener esa tendencia para el precio, la disponibilidad y la evolución de las herramientas de inteligencia artificial.
La carrera de la IA también se decide en los centros de datos
Cuando se habla de inteligencia artificial generativa, la atención suele centrarse en el tamaño del modelo, la calidad de sus respuestas o las nuevas funciones que aparecen en una aplicación. Sin embargo, cada petición debe ejecutarse en hardware real. Los modelos necesitan realizar operaciones matemáticas a gran escala, mover datos entre memoria y unidades de cálculo y comunicarse con otros procesadores cuando la carga de trabajo es demasiado grande para un único chip.
Entrenar un modelo y utilizarlo una vez entrenado son tareas relacionadas, pero distintas. El entrenamiento ajusta sus parámetros a partir de grandes cantidades de datos y puede requerir una infraestructura muy intensiva. La inferencia es la fase en la que el modelo responde a una pregunta, resume un documento, genera código o produce una imagen. En servicios con millones de usuarios, la inferencia se repite continuamente y el coste acumulado puede ser enorme.
Por eso Microsoft está poniendo un énfasis particular en los aceleradores diseñados para inferencia. Un chip especializado puede optimizar el tipo de cálculo, el acceso a memoria y la comunicación que predominan en esas cargas. La palabra clave es «especializado»: no existe un procesador perfecto para todas las tareas, y el mejor resultado depende del modelo, la precisión numérica, el tamaño de los lotes, la memoria disponible y el sistema completo.
Maia no es un único chip: es una familia de aceleradores
Microsoft presentó Maia 100 en 2023 como su primer acelerador propio para cargas de inteligencia artificial en Azure, tal como explicó en su documentación técnica sobre Maia 100. En la documentación técnica posterior explicó que el proyecto se diseñó junto con la infraestructura que lo rodea, desde la distribución de energía y la refrigeración hasta las herramientas de software. No se trataba simplemente de producir un componente alternativo, sino de adaptar el sistema completo a las necesidades de los modelos que Microsoft ejecuta en sus centros de datos.
La siguiente generación, Maia 200, se anunció oficialmente el 26 de enero de 2026, en una presentación que puede consultarse en el blog oficial de Microsoft. Microsoft la describe como un acelerador centrado en la inferencia. Según sus especificaciones publicadas, está fabricado con tecnología de proceso de 3 nanómetros, integra 216 GB de memoria HBM3e con un ancho de banda de 7 TB/s y dispone de 272 MB de SRAM en el chip. La compañía también indica más de 140.000 millones de transistores y un consumo térmico de diseño de 750 vatios para el SoC.
Estas cifras sirven para dimensionar el tipo de hardware del que hablamos, pero no bastan por sí solas para declarar un ganador. La capacidad de memoria ayuda a mantener modelos y datos accesibles; el ancho de banda influye en la rapidez con la que se alimentan las unidades de cálculo; y la potencia de cálculo indica cuántas operaciones puede realizar el chip bajo determinadas condiciones. Para comparar sistemas de forma justa también hay que considerar el software, la latencia, la utilización efectiva y el coste de toda la instalación.
Microsoft afirma que Maia 200 ofrece un 30 % más de rendimiento por dólar que el hardware de última generación que utilizaba anteriormente en su flota. Es una cifra comunicada por la propia empresa y debe interpretarse en ese contexto: describe la comparación que Microsoft ha realizado con sus sistemas, no una prueba independiente que garantice la misma ventaja en cualquier carga de trabajo. El rendimiento real puede cambiar según el modelo y la configuración.
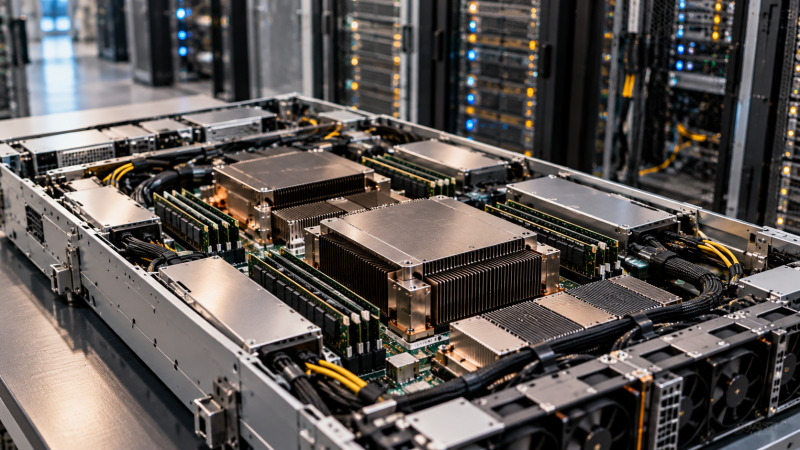
El siguiente paso: Maia 300 y una infraestructura de mayor escala
El anuncio del 12 de octubre de 2026 sitúa el foco en Maia 300 y en la expansión de toda la plataforma. La noticia también ha sido recogida por Reuters, que aporta contexto sobre la dimensión económica del plan. Microsoft señala que Maia 200 ya está ejecutando cargas de producción, entre ellas Microsoft Copilot, y que el sistema se ampliará a despliegues de varios gigavatios a partir de 2027. También prevé que GitHub Copilot y Microsoft Foundry incorporen Maia 200 antes de que termine 2026, según el calendario que la compañía comunicó en su blog oficial.
Para Maia 300, Microsoft anticipa una mejora del 40 % en tokens por megavatio frente a sistemas líderes basados en GPU. En una configuración de 96 aceleradores por rack, la empresa calcula hasta siete veces el rendimiento de tokens a escala de rack respecto a Maia 200. Son objetivos y comparaciones declarados por Microsoft, no resultados que deban extrapolarse sin más a todos los modelos o servicios. La empresa no ha publicado todavía, en el anuncio citado, todos los detalles necesarios para que un tercero reproduzca cada comparación de manera independiente.
La meta de varios gigavatios muestra, sobre todo, la dimensión física de la carrera. Un gigavatio equivale a mil millones de vatios de potencia. Las cifras de esa escala describen una infraestructura que necesita planificación energética, suministro eléctrico, refrigeración, espacio, redes y una cadena de fabricación capaz de entregar los componentes. La disponibilidad de chips no es el único cuello de botella: también lo son la construcción de centros de datos, la conexión a la red eléctrica y la puesta en servicio de sistemas complejos.
Por qué diseñar silicio propio puede cambiar la economía de la IA
El argumento empresarial no consiste únicamente en pagar menos por cada chip. Un acelerador diseñado para una carga concreta puede reducir el coste de ejecutar cada tarea si logra mantener las unidades de cálculo ocupadas, mover los datos con eficiencia y aprovechar mejor la memoria. A gran escala, incluso una mejora relativamente pequeña por petición puede representar una diferencia importante cuando millones de solicitudes se procesan cada día.
Hay además una ventaja de planificación. Cuando una empresa depende por completo de componentes de terceros, sus opciones quedan condicionadas por la disponibilidad, los calendarios de lanzamiento, las prioridades de otros clientes y los precios del mercado. Desarrollar una alternativa interna no elimina esas dependencias —la fabricación avanzada sigue requiriendo socios especializados—, pero puede dar más margen para decidir qué capacidad necesita y cuándo desplegarla.
El diseño propio también permite integrar el hardware con el software. Microsoft trabaja en herramientas de desarrollo para Maia, con integración para PyTorch, un compilador Triton, bibliotecas de kernels optimizados y herramientas de bajo nivel. El objetivo es que los desarrolladores puedan adaptar modelos y operaciones al acelerador sin tener que programar cada detalle desde cero. La existencia de un ecosistema de software útil es decisiva: un chip potente que resulte difícil de utilizar puede terminar infrautilizado.
Este enfoque no es exclusivo de Microsoft. Los grandes operadores de nube llevan tiempo desarrollando sus propios aceleradores, porque controlan tanto las aplicaciones como una parte sustancial de la infraestructura que las ejecuta. Google cuenta con sus TPU y Amazon con la familia Trainium, entre otros ejemplos. La estrategia responde a una tendencia del sector: diversificar el hardware y optimizarlo para cargas de trabajo propias, en lugar de depender de una arquitectura única para todo.
¿Significa esto que Microsoft quiere dejar de usar NVIDIA?
No hay base para afirmar que Microsoft vaya a abandonar de golpe las GPU de NVIDIA. El anuncio oficial describe Maia como parte de una infraestructura heterogénea, es decir, un entorno que combina distintos tipos de procesadores según el trabajo que debe realizarse. Microsoft también continúa trabajando con proveedores externos de hardware y ha anunciado inversiones en otras plataformas de cómputo. Tener un acelerador propio amplía las opciones; no obliga a reemplazar todo lo demás.
Las GPU de propósito general siguen siendo importantes para entrenar y ejecutar una amplia variedad de modelos, y su ecosistema de software, herramientas y experiencia acumulada constituye una ventaja considerable. Un acelerador personalizado puede destacar en tareas concretas y, aun así, no ser la mejor opción para todas las fases del desarrollo de IA. La decisión se toma por carga de trabajo, disponibilidad, coste total y requisitos técnicos, no por una única cifra de rendimiento.
También existe una diferencia entre reducir la dependencia de un proveedor y alcanzar independencia tecnológica completa. La fabricación de chips de vanguardia está concentrada en un pequeño número de empresas y regiones. Incluso si Microsoft diseña la arquitectura, necesita socios para producir el silicio, empaquetarlo, suministrar memoria avanzada y fabricar otros componentes. Las restricciones de capacidad, los plazos y la geopolítica continúan influyendo en la cadena de suministro.
En otras palabras, el objetivo razonable es diversificar y ganar capacidad de negociación, no hacer desaparecer las interdependencias que caracterizan a la industria de semiconductores. La autonomía de diseño aporta control sobre algunas decisiones, pero no elimina los riesgos de suministro ni garantiza que cada generación supere a todas las alternativas.
La eficiencia energética ya forma parte del rendimiento
Los centros de datos dedicados a IA consumen electricidad para los procesadores, pero también para memoria, redes, almacenamiento, sistemas de alimentación y refrigeración. Este contexto se amplía en nuestro análisis sobre el consumo energético de los centros de datos de inteligencia artificial. En instalaciones de gran tamaño, mejorar la eficiencia por tarea puede ayudar a contener tanto el coste operativo como la demanda energética. Aun así, un chip más eficiente no implica necesariamente que el consumo total de la empresa vaya a bajar.
Si la reducción del coste permite ofrecer más funciones, atraer más usuarios o ejecutar modelos con mayor frecuencia, la demanda total puede crecer y compensar parte de la mejora. Es un efecto que conviene tener presente al leer anuncios sobre tokens por vatio o rendimiento por megavatio: la eficiencia de una unidad de trabajo y el consumo agregado de una plataforma son medidas diferentes.
Por eso resulta más útil observar varias métricas a la vez. La eficiencia energética debe relacionarse con la cantidad de tareas útiles completadas, la calidad de los resultados, la latencia y el coste total de propiedad. También importa la utilización real del hardware: un acelerador excelente sobre el papel puede desperdiciar energía si pasa demasiado tiempo esperando datos o si el software no consigue distribuir bien la carga.
Qué puede notar el usuario y qué no debería darse por hecho
Para quien utiliza Copilot u otro asistente, el cambio de procesador normalmente no se traduce en un botón nuevo ni en una función visible de inmediato. Sus efectos potenciales son más indirectos: más capacidad para atender peticiones, tiempos de respuesta más estables, costes operativos menores o margen para desplegar modelos más grandes. Cada resultado depende de cómo se integre el hardware y de las decisiones comerciales del proveedor.
Una reducción de costes tampoco garantiza que las suscripciones bajen de precio. Una empresa puede destinar el ahorro a ampliar capacidad, financiar el desarrollo de nuevos modelos, mejorar la disponibilidad o mantener márgenes. Del mismo modo, un aumento de rendimiento no asegura que todas las consultas sean más rápidas: la latencia depende de la longitud del contexto, del tamaño del modelo, de la congestión, de la red y de los pasos que requiere cada petición.
Conviene distinguir también entre entrenamiento e inferencia al evaluar anuncios. Maia 200 se presenta principalmente como un acelerador de inferencia, aunque Microsoft señala otros usos internos relacionados con la generación de datos sintéticos y el aprendizaje por refuerzo. Esto no permite concluir que todos los procesos de entrenamiento de Microsoft vayan a migrar a Maia ni que el mismo hardware sea óptimo para cualquier fase del ciclo de vida de un modelo.
Para empresas que contratan servicios de IA en la nube, la pregunta práctica no es qué marca aparece en el chip, sino qué garantías ofrece el servicio: disponibilidad, rendimiento bajo carga, ubicación y tratamiento de los datos, compatibilidad con sus aplicaciones, límites de uso, precio y condiciones de salida. La arquitectura interna puede cambiar sin que el cliente tenga control sobre ella. Por eso conviene evaluar el servicio por resultados verificables y no por el nombre de su procesador.
Los riesgos de una estrategia de chips propios
Desarrollar semiconductores avanzados requiere inversiones elevadas, equipos especializados y varios años de trabajo. Los plazos son largos: una arquitectura debe definirse antes de conocer con precisión qué modelos serán dominantes cuando el producto llegue a producción. Si cambian las necesidades, una parte de las decisiones de diseño puede quedar desfasada. La inversión tampoco termina cuando el chip funciona; hacen falta validación, software, soporte, actualizaciones y nuevas generaciones.
Existe el riesgo de fragmentación. Si cada proveedor de nube construye sus propios aceleradores, los desarrolladores pueden tener que adaptar kernels, herramientas y modelos a varios entornos. Las capas de abstracción y los estándares abiertos ayudan, pero no garantizan que el mismo código alcance el mismo rendimiento en todas las arquitecturas. La portabilidad real debe probarse con cargas concretas, no suponerse a partir de que dos plataformas admitan una misma biblioteca.
Otro límite es que las cifras comunicadas por el fabricante suelen reflejar condiciones seleccionadas para mostrar las ventajas del producto. No es una razón para descartarlas, sino para leerlas con criterio. Para evaluar una mejora hacen falta detalles sobre el modelo usado, la precisión numérica, el tamaño de la carga, el consumo medido, la configuración del sistema y la comparación de referencia. La misma cautela se aplica a las respuestas generadas por modelos, como explicamos en nuestra guía sobre las alucinaciones de la inteligencia artificial. Sin esos datos, los porcentajes ofrecen una orientación, pero no una conclusión universal.
Cómo leer los anuncios de nuevos aceleradores sin quedarse en el titular
Cuando se anuncie una nueva generación, merece la pena comprobar primero qué está disponible y qué sigue siendo una previsión. Un chip anunciado no equivale a un producto desplegado; un despliegue inicial no significa disponibilidad en todas las regiones; y una cifra estimada por el fabricante no es necesariamente un resultado validado por terceros. En el caso de Maia, Microsoft ha diferenciado entre Maia 200, que declara ya en producción, y Maia 300, cuya expansión sitúa a partir de 2027.
Después, hay que identificar la carga para la que se diseñó el procesador. La inferencia de modelos de lenguaje, el entrenamiento, la generación de imágenes y la computación científica no tienen exactamente los mismos requisitos. Una comparación útil especifica qué modelo ejecuta, cuánta memoria utiliza, qué precisión numérica aplica y cómo se mide el rendimiento. Sin esa información, comparar dos números aislados puede llevar a conclusiones equivocadas.
La documentación primaria más útil en este caso es la que publica Microsoft sobre Maia 200 y el plan de expansión de octubre de 2026. Para consultar el resumen de producto, también está disponible la página oficial de Maia 200. Es la fuente directa para conocer las especificaciones y los objetivos declarados, aunque también es una fuente interesada cuando compara su producto con alternativas del mercado. Para tomar decisiones técnicas o de compra, esas afirmaciones deberían complementarse con pruebas independientes cuando estén disponibles y con mediciones sobre el trabajo real que se pretende ejecutar.
Conclusión: el hardware invisible también define el futuro de la IA
La apuesta de Microsoft por Maia ilustra un cambio importante: competir en inteligencia artificial ya no consiste solo en crear modelos o diseñar aplicaciones. También exige controlar una infraestructura que combina silicio, memoria, redes, refrigeración, energía y software. Maia 200 representa la fase que Microsoft afirma tener ya en producción, mientras que Maia 300 y los despliegues multigigavatio forman parte de su hoja de ruta para los próximos años.
El movimiento puede mejorar la eficiencia y dar a Microsoft más opciones frente a los proveedores de GPU, pero no supone el fin de NVIDIA ni garantiza por sí solo servicios más baratos. La fabricación avanzada, el software, la energía y la demanda siguen imponiendo límites. La prueba definitiva llegará cuando existan despliegues amplios y comparaciones transparentes con cargas de trabajo representativas.
Para profesionales y empresas, la lección es sencilla: detrás de cada herramienta de IA hay una infraestructura que condiciona su coste y su disponibilidad. Entender esa capa permite valorar mejor las promesas de rendimiento y hacer preguntas más concretas a los proveedores. Y, como ocurre con cualquier tecnología, conviene decidir por resultados comprobables, no solo por cifras llamativas en una presentación.
Preguntas frecuentes
¿Qué es Maia de Microsoft?
Es una familia de aceleradores de inteligencia artificial diseñada para la infraestructura de Azure. Maia 100 fue la primera generación anunciada; Maia 200 se orienta principalmente a la inferencia y Microsoft ha presentado Maia 300 como la siguiente fase de su hoja de ruta.
¿Microsoft dejará de utilizar chips de NVIDIA?
No hay indicios oficiales de una retirada completa. La compañía describe una infraestructura heterogénea que combina distintas plataformas según la carga de trabajo. Maia amplía sus opciones, pero no elimina la necesidad de evaluar procesadores de terceros.
¿Los chips propios harán que la IA sea más barata?
Pueden reducir determinados costes si mejoran el rendimiento por unidad de energía o por dólar, pero el precio final depende también de la infraestructura, la demanda, el software y la estrategia comercial. El ahorro técnico no garantiza una bajada de las tarifas.
¿Cuándo llegará Maia 300?
En su anuncio del 12 de octubre de 2026, Microsoft situó el inicio de los despliegues multigigavatio de la familia Maia a partir de 2027. Esa fecha describe la hoja de ruta comunicada por la empresa, no una disponibilidad universal para clientes desde un día concreto.
En Joan Alonso Design analizamos herramientas y tecnología con una mirada práctica: comprender qué hay detrás de una novedad ayuda a elegir mejor las soluciones digitales y a planificar proyectos web con criterios técnicos, no solo por tendencias.