Revolut ha reconocido en septiembre de 2026 un incidente poco habitual: una tercera persona consiguió que la entidad entregara información sensible de clientes después de hacerse pasar por un organismo público mediante una dirección de correo perteneciente a un dominio gubernamental legítimo. No fue necesario entrar en los servidores del banco ni robar una base de datos. El engaño funcionó en una capa anterior: la verificación de una petición que parecía formar parte de un procedimiento oficial.
El caso es especialmente interesante porque muestra una idea que a veces se pierde cuando hablamos de ciberseguridad: proteger los datos no consiste únicamente en levantar barreras técnicas alrededor de los sistemas. También hay que comprobar quién solicita una información, con qué autoridad lo hace, qué datos necesita realmente y mediante qué canal debe verificarse esa solicitud.
Las primeras informaciones hablaban de un número limitado de afectados. El 14 de septiembre, el relato publicado por TechCrunch recogía que la información potencialmente expuesta podía incluir datos de identidad y contacto, documentos de identidad, selfies de verificación, extractos y movimientos. Días después, el Financial Times informó de que Revolut había contactado con 680 clientes afectados. Esa cifra debe entenderse como el alcance identificado en la investigación disponible hasta ahora, no como una garantía de que el análisis haya terminado.
Qué ocurrió realmente con Revolut
Según la explicación pública de Revolut, el incidente comenzó con una solicitud fraudulenta de información. El remitente utilizó una dirección asociada a un dominio legítimo de una agencia gubernamental. Esa diferencia es importante: no estamos ante el simple uso de un dominio parecido, una dirección inventada o un mensaje que cualquiera pudiera reconocer como falso a primera vista.
La petición parecía encajar con una comunicación oficial y fue procesada como una solicitud legítima. El resultado fue que Revolut proporcionó información de determinados clientes a una persona que no estaba autorizada para recibirla. La compañía describió el episodio como una «sofisticada estafa externa de suplantación» y afirmó que, al detectarlo, bloqueó la dirección utilizada, avisó al organismo afectado y notificó a fuerzas de seguridad, autoridades de protección de datos y reguladores financieros.
El 16 de septiembre, la agencia italiana ANSA informó de que la policía postal italiana también había abierto una investigación, después de que las informaciones sobre el caso apuntaran al uso de una cuenta de correo gubernamental italiana. Ese detalle seguía formando parte de una investigación abierta y no debe confundirse con una confirmación de que los sistemas de una administración italiana hubieran sido comprometidos.
La propia Revolut ha sostenido que sus sistemas y los fondos de los clientes no se vieron afectados. La diferencia entre esta afirmación y una intrusión convencional es fundamental: los atacantes no necesitaban obtener acceso técnico a la infraestructura bancaria si podían conseguir que una organización con acceso legítimo a los datos se los entregara.
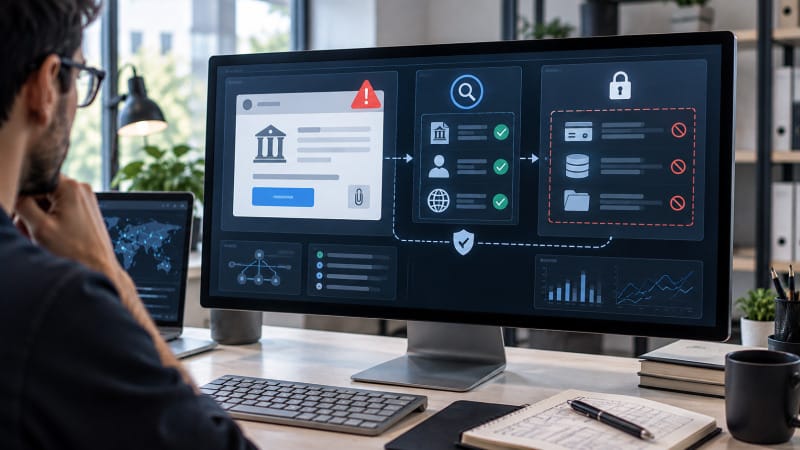
No fue un «hackeo» clásico: fue un problema de confianza
La palabra «hackeo» resulta cómoda para describir cualquier incidente digital, pero aquí puede llevar a una conclusión equivocada. La información disponible describe un ataque de ingeniería social y suplantación dirigido contra el proceso de atención de solicitudes, no una intrusión demostrada en los sistemas centrales de Revolut.
La diferencia puede parecer semántica, pero tiene consecuencias prácticas. Un cortafuegos puede impedir una conexión no autorizada y una autenticación multifactor puede proteger una cuenta. Ninguna de esas medidas, por sí sola, determina si una petición recibida desde un canal aparentemente oficial debe considerarse válida.
El atacante explotó precisamente esa zona de confianza. Una dirección procedente de un dominio gubernamental real puede superar comprobaciones técnicas relacionadas con el dominio y, aun así, estar siendo utilizada de forma indebida. La autenticidad del canal no demuestra automáticamente la legitimidad de la persona que lo utiliza ni de la petición concreta que realiza.
El caso también demuestra por qué la seguridad de la información tiene una dimensión organizativa. La guía del Information Commissioner’s Office sobre seguridad de los datos insiste en que la protección de datos debe combinar medidas técnicas y organizativas, evaluación de riesgos, políticas, controles de acceso, formación y revisión periódica de las medidas. No basta con proteger servidores si el proceso que permite extraer información legítimamente no está diseñado para resistir una suplantación convincente.
Qué datos pudieron quedar expuestos
La notificación recibida por los clientes afectados, según la información revisada por TechCrunch, contemplaba diferentes categorías de datos. Entre ellas aparecen fecha de nacimiento, dirección postal, correo electrónico y teléfono, además de copias de documentos de identidad como pasaportes o permisos de conducir. También podían estar incluidos selfies utilizados para verificación, extractos de cuenta e historiales de transacciones.
Otras informaciones publicadas posteriormente mencionaron IBAN, registros de retiradas y actividad relacionada con criptomonedas. Conviene mantener una distinción importante: no todos esos datos tienen por qué corresponder a todas las personas afectadas. La información comunicada a cada cliente depende de los registros concretos que fueron solicitados y entregados.
El riesgo principal tampoco es necesariamente que alguien pueda entrar directamente en una cuenta bancaria. Una combinación de identidad, dirección, documentos y actividad financiera puede servir para construir ataques posteriores mucho más creíbles. Un delincuente que conoce el nombre del cliente, parte de su historial y detalles de verificación tiene más posibilidades de fabricar un mensaje convincente que alguien que solo dispone de una dirección de correo.
En otras palabras, el incidente puede convertirse en materia prima para nuevos intentos de fraude. Esa segunda fase es especialmente relevante porque un dato filtrado no siempre produce un daño inmediato: puede utilizarse semanas o meses después para intentar suplantar a un banco, una empresa, un organismo público o incluso al propio cliente.
Por qué un dominio gubernamental no basta para verificar una petición
El punto técnico más interesante del caso está en separar identidad técnica y autoridad. Un sistema de correo puede demostrar que un mensaje procede de una infraestructura asociada a un dominio determinado. Eso ayuda a combatir determinados tipos de falsificación, pero no resuelve por sí solo quién está autorizado a pedir información ni si la petición es auténtica.
Imaginemos una empresa que recibe una solicitud para entregar datos de un cliente. El mensaje parece proceder de una administración, contiene referencias coherentes y llega desde un dominio real. La primera comprobación puede salir correctamente. Aun así, quedan otras preguntas: ¿la persona que envía la solicitud está autorizada?, ¿el procedimiento exige una segunda validación?, ¿la petición tiene un número de expediente verificable?, ¿los datos solicitados son proporcionales?, ¿puede confirmarse la solicitud por un canal independiente?
Ese modelo se parece a la seguridad de una web o de una aplicación. Saber que una petición llega desde una dirección conocida no equivale a demostrar que la operación concreta es segura. La identidad debe ir acompañada de autorización y contexto.
El principio de seguridad explicado por el ICO establece que los datos personales deben protegerse frente al tratamiento no autorizado o ilícito mediante medidas técnicas y organizativas apropiadas. También existe una idea complementaria de minimización: incluso cuando una solicitud es legítima, debería entregarse únicamente la información necesaria para la finalidad correspondiente.
La lección para cualquier empresa que maneje datos personales
Revolut es una entidad financiera con una enorme cantidad de información sensible, pero el problema que revela este caso no pertenece únicamente a los bancos. Una agencia de diseño puede gestionar datos de clientes, una tienda online conserva direcciones y pedidos, una clínica administra documentación personal y una empresa pequeña puede recibir solicitudes legales por correo electrónico. En ese contexto, conviene entender también cómo la ingeniería social y el fraude digital pueden convertir información aparentemente inocua en una herramienta para nuevos engaños.
La primera medida debería ser separar la recepción de una solicitud de su aprobación. Que un mensaje llegue a una bandeja atendida por personal autorizado no significa que la información solicitada pueda salir automáticamente. Debe existir un proceso claro para comprobar identidad, autoridad, alcance y necesidad.
1. Verificar por un segundo canal
Cuando una solicitud implica datos especialmente sensibles, la confirmación independiente puede romper la cadena de confianza falsa. Una llamada a un número oficial obtenido por una fuente independiente, un portal institucional o un procedimiento previamente acordado pueden servir para confirmar que la petición existe realmente.
2. Limitar los datos que puede recibir cada solicitud
No todas las peticiones necesitan el mismo nivel de información. Un procedimiento bien diseñado debería distinguir entre datos básicos, documentos de identidad, información financiera y datos especialmente delicados. Cuanto mayor sea el impacto potencial, mayor debe ser el nivel de validación exigido.
3. Registrar quién autorizó la entrega
La trazabilidad es tan importante como el control inicial. Cada acceso o exportación de datos debería dejar constancia suficiente para reconstruir qué se solicitó, quién lo aprobó, qué información salió y por qué. Los registros no evitan por sí solos un engaño, pero permiten detectarlo y limitar sus consecuencias.
4. Formar al personal con casos realistas
La formación contra el phishing suele centrarse en mensajes con errores evidentes. Los ataques de suplantación más convincentes pueden ser mucho más limpios: lenguaje correcto, referencias reales, dominios auténticos y una petición aparentemente rutinaria. Por eso los ejercicios de seguridad deberían incluir escenarios donde el canal es auténtico pero la intención no lo es.
5. Diseñar la privacidad desde el proceso, no al final
La protección de datos debe formar parte del diseño de los procedimientos. La documentación del ICO sobre privacidad desde el diseño insiste en integrar medidas técnicas y organizativas desde el inicio y durante todo el ciclo de vida del tratamiento. La pregunta no debería ser únicamente «¿cómo protegemos esta base de datos?», sino también «¿qué condiciones deben cumplirse para que un dato pueda salir de ella?».
Qué deberían revisar las webs y pequeños negocios
Para una pyme, el caso de Revolut puede parecer lejano porque probablemente no recibe requerimientos de organismos públicos con frecuencia. Sin embargo, el patrón es reconocible en situaciones mucho más sencillas: alguien se hace pasar por un proveedor, un cliente, un abogado, un transportista o un técnico y solicita acceso a información que normalmente no pediría.
En una web WordPress, por ejemplo, no basta con mantener el CMS y los plugins actualizados. También resulta útil revisar periódicamente los criterios básicos de una seguridad de una web, especialmente cuando existen cuentas administrativas, formularios o servicios que procesan datos personales. También conviene revisar quién puede acceder a los datos de clientes, qué cuentas administrativas existen, qué servicios de terceros reciben información y qué acciones requieren una segunda comprobación. En una tienda WooCommerce, una exportación de pedidos puede contener nombres, direcciones, teléfonos y otros datos que no deberían circular sin control.
Esta revisión encaja con la lógica de seguridad por capas. La autenticación protege cuentas; los permisos limitan lo que puede hacer cada usuario; los registros permiten investigar; la segmentación reduce el alcance de un incidente; y los procedimientos internos dificultan que una persona pueda ser convencida para saltarse una comprobación.
En ese contexto también resulta útil revisar las medidas de acceso y autenticación de una web. Las passkeys y otros mecanismos de autenticación resistente al phishing pueden reducir determinados riesgos de acceso a cuentas, aunque no sustituyen los controles necesarios para decidir cuándo debe compartirse información con un tercero.
Qué significa el incidente para los clientes afectados
Revolut ha comunicado directamente con las personas que identificó como afectadas. Para esos clientes, la prioridad no debería ser asumir que la cuenta bancaria ha sido tomada, porque la compañía afirma que los fondos y sus sistemas no fueron afectados. El riesgo más inmediato puede estar en los intentos de fraude que aprovechen los datos personales ya expuestos.
Un cliente que reciba comunicaciones posteriores que mencionen información que solo parecía conocer el banco debería extremar la precaución. La mejor defensa es no continuar una conversación iniciada desde un mensaje inesperado y comprobar cualquier incidencia desde la aplicación o desde canales oficiales obtenidos directamente, no mediante enlaces o teléfonos incluidos en el propio mensaje.
También conviene desconfiar de cualquier persona que utilice datos reales para ganar credibilidad. Saber el número de teléfono, una dirección, un documento o detalles de una transacción no demuestra que quien los menciona sea un empleado de Revolut. Precisamente esos datos pueden proceder del incidente.
Lo que todavía no sabemos
La investigación sigue abierta y hay aspectos que no deben presentarse como hechos cerrados. Revolut no ha publicado públicamente todos los detalles del organismo cuyo dominio fue utilizado ni ha descrito con precisión cada paso interno que permitió procesar las solicitudes. La cifra de 680 clientes procede de las informaciones publicadas sobre las personas identificadas hasta ahora y puede cambiar si la investigación descubre nuevos afectados.
Tampoco debe darse por demostrado que una administración concreta fue comprometida técnicamente solo porque una cuenta de correo gubernamental fuera utilizada. Las autoridades italianas han abierto una investigación precisamente para determinar qué ocurrió con esa cuenta y cuál fue el origen del acceso.
Por último, las afirmaciones de personas o grupos que dicen disponer de más datos o que amenazan con publicar información deben separarse de los hechos confirmados por Revolut y de los datos comunicados por medios que han podido revisar documentación del caso. En un incidente en curso, repetir cada afirmación como si fuera una prueba ampliaría el problema en lugar de aclararlo.
La verdadera lección: verificar la autoridad, no solo la identidad
El incidente de Revolut deja una enseñanza que sirve mucho más allá de esta empresa. La seguridad moderna no consiste en asumir que una comunicación es fiable porque supera una comprobación técnica. Un dominio auténtico puede ser utilizado para una petición fraudulenta; una cuenta legítima puede estar siendo utilizada por una persona no autorizada; y un procedimiento correcto puede convertirse en una vía de salida de información si falta una segunda capa de verificación.
Por eso, las organizaciones que manejan datos personales deberían tratar la entrega de información como una operación sensible por derecho propio. Identidad, autoridad, necesidad, alcance y trazabilidad forman un conjunto. Si una de esas piezas falla, las demás pueden no ser suficientes para detener el engaño.
Para quienes trabajamos con webs, tiendas online y sistemas digitales, la conclusión es práctica: la seguridad no termina en el candado del navegador ni en el formulario de acceso. También está en los permisos, en los procesos, en las personas y en las decisiones que permiten que un dato pase de un sistema a otro. Diseñar bien esa cadena es una parte esencial de construir una web y una infraestructura digital realmente seguras.
Preguntas frecuentes
¿Revolut fue hackeado?
Según la información publicada por la propia entidad y recogida por medios especializados, el incidente se produjo mediante una suplantación externa que consiguió que Revolut entregara información a una persona no autorizada. No se ha descrito públicamente como una intrusión que comprometiera los sistemas centrales o los fondos de los clientes.
¿Cuántos clientes fueron afectados?
Las informaciones publicadas el 14 y 15 de septiembre de 2026 situaron la cifra en 680 clientes identificados. Revolut había hablado inicialmente de un número limitado o muy limitado de personas afectadas. Como la investigación continúa, conviene tratar 680 como la cifra comunicada hasta ahora, no necesariamente como el recuento definitivo.
¿Qué datos se expusieron?
Dependiendo del cliente, la información podía incluir datos de contacto e identidad, documentos como pasaportes o permisos de conducir, selfies de verificación, extractos y datos de transacciones. Algunas informaciones también mencionaron IBAN y actividad relacionada con criptomonedas. No significa que todos los datos correspondieran a todas las personas afectadas.
¿Qué puede aprender una pequeña empresa de este caso?
La lección principal es establecer un proceso de verificación independiente para solicitudes que impliquen datos sensibles. También conviene aplicar permisos mínimos, registrar accesos y exportaciones, limitar la información entregada a la estrictamente necesaria y formar al personal para reconocer suplantaciones convincentes, incluso cuando el canal utilizado sea técnicamente auténtico.
En seguridad digital, los problemas más importantes no siempre aparecen como una puerta forzada. A veces aparecen como una puerta que alguien abre porque la persona que llama parece tener la llave.