Durante años, quien administra una web y quiere limitar el uso de sus contenidos por sistemas de inteligencia artificial ha tenido que aprender los nombres de distintos rastreadores y mantener reglas separadas para cada empresa. Esa fragmentación podría empezar a cambiar. El 30 de octubre de 2026, OpenAI, Google y Microsoft anunciaron su apoyo —con calendarios y compromisos distintos— a una señal compartida que permitirá expresar preferencias sobre el entrenamiento de modelos desde el archivo robots.txt.
La iniciativa se apoya en un trabajo del grupo de preferencias de IA de la Internet Engineering Task Force (IETF), conocido como AIPREF. Su objetivo es reducir la complejidad para editores, empresas, medios y propietarios de sitios web. Sin embargo, hay una diferencia importante entre anunciar que se apoyará una propuesta y disponer ya de un estándar implantado por todos. A fecha de 3 de noviembre de 2026, el mecanismo sigue en desarrollo y su adopción será progresiva.
Para quienes gestionan una web con WordPress, publican artículos o mantienen una tienda en línea, la noticia merece atención. Puede simplificar la comunicación de preferencias, pero no convierte robots.txt en una barrera técnica infranqueable ni resuelve por sí sola todas las formas en que un contenido puede utilizarse.
Qué han anunciado OpenAI, Google y Microsoft
El anuncio conjunto de apoyo no significa que las tres compañías hayan activado ya el mismo control. Cada una ha explicado un calendario y un alcance propios. Conviene separar esos compromisos para no dar por disponible una función que todavía no se ha desplegado.
OpenAI prevé implementar la señal en los próximos meses
OpenAI publicó el 30 de octubre que respetará una señal común en robots.txt para que los sitios puedan expresar sus preferencias sobre el uso de sus contenidos en el entrenamiento de modelos fundacionales de IA generativa. La compañía explica que, hasta ahora, los administradores debían identificar sus rastreadores y mantener reglas específicas. El objetivo de la señal compartida es permitir que una misma preferencia pueda ser reconocida por varios proveedores participantes.
La formulación de OpenAI es concreta, pero todavía no equivale a una función disponible para configurar en cualquier web: la empresa dice que su intención es implementarla durante los próximos meses y que comunicará más detalles cuando avance el despliegue. Por tanto, no conviene modificar ahora un archivo de producción suponiendo que el nuevo token ya controla el comportamiento de sus rastreadores.
Anuncio oficial de OpenAI sobre las preferencias de entrenamiento.
Google apunta a 2027 y mantiene Google-Extended
Google también anunció el 30 de octubre su intención de admitir un control compartido en robots.txt. La compañía explica que la señal permitirá establecer una preferencia general para varios proveedores y que sus controles específicos seguirán funcionando. Entre ellos está Google-Extended, el token que Google introdujo en 2023 para que los editores gestionen determinados usos de sus contenidos relacionados con Gemini.
Google indica que, si un sitio utiliza la nueva señal para rechazar el entrenamiento y no establece una instrucción específica contraria mediante Google-Extended, interpretará esa preferencia compartida como una desautorización de Google-Extended. Su documentación de rastreadores sitúa el apoyo previsto a la señal común a comienzos de 2027. La compañía también aclara que Google-Extended no afecta a la inclusión de una web en la Búsqueda de Google ni funciona como señal de posicionamiento.
Esta distinción es esencial: Google separa el rastreo necesario para la Búsqueda de otros usos relacionados con el entrenamiento y la fundamentación de respuestas de IA. Bloquear un uso no implica automáticamente bloquear los demás.
Anuncio de Google Search Central y documentación oficial sobre Google-Extended.
Microsoft diferencia entrenamiento y fundamentación de respuestas
Microsoft presentó el mismo día una actualización de sus preferencias para editores. La compañía respalda la señal compartida de entrenamiento y, al mismo tiempo, plantea controles propios para decidir cómo puede utilizarse el contenido para fundamentar respuestas generadas por IA. En su publicación distingue entre AI Training y AI Grounding.
El entrenamiento se refiere al uso de contenidos para desarrollar o mejorar modelos. La fundamentación, también llamada grounding, consiste en recuperar información de una página para ayudar a elaborar una respuesta concreta, por ejemplo en Copilot o en experiencias de Microsoft 365. Son usos distintos y no tienen por qué recibir la misma preferencia.
Microsoft indica que trabaja con otros participantes en la señal compartida y ofrece ejemplos de cómo expresarla en robots.txt. También explica que sus controles de fundamentación serán independientes y que las preferencias no cambiarán la elegibilidad de una web para aparecer en los resultados de Bing. Su calendario pide a los editores publicar sus ajustes antes del 1 de marzo de 2027, dentro de la transición descrita por la compañía.
Publicación oficial de Microsoft Bing sobre entrenamiento y grounding.
¿Y Anthropic?
La propuesta técnica que ha dado visibilidad a esta señal aparece en un borrador de Internet-Draft cuyo autor, Kevin Kelley, figura afiliado a Anthropic. El documento describe un token de política para preferencias de entrenamiento y plantea cómo expresarlo en grupos de robots.txt. Esa relación es relevante para entender el origen del trabajo, pero no debe confundirse automáticamente con una fecha de despliegue ni con un compromiso de implementación detallado por parte de toda la compañía. La situación debe comprobarse en los anuncios oficiales de cada proveedor conforme avance el proyecto.
Qué es robots.txt y qué puede hacer realmente
robots.txt es un archivo de texto que se publica en la raíz de un dominio, normalmente en una dirección como https://ejemplo.com/robots.txt. Sirve para comunicar instrucciones a los rastreadores automáticos sobre las rutas a las que pueden acceder. Es una herramienta antigua y conocida en SEO técnico, utilizada para orientar el comportamiento de buscadores y otros bots.
Un archivo sencillo puede incluir reglas para todos los rastreadores o para uno concreto. Por ejemplo:
User-agent: *
Disallow: /zona-privada/

User-agent: Googlebot
Allow: /
El ejemplo solo ilustra la estructura habitual de grupos y reglas. No es una configuración recomendada para cualquier instalación: cada web debe revisar sus rutas, los rastreadores que necesita permitir y las consecuencias de cada regla. Un error puede impedir que un buscador acceda a recursos importantes o que un bot legítimo rastree páginas que deberían ser públicas.
La especificación oficial del protocolo, publicada como RFC 9309, deja claro un límite que suele olvidarse: las reglas de robots.txt no son un mecanismo de autorización ni de control de acceso. Expresan instrucciones que los rastreadores conformes deben interpretar, pero no protegen un recurso frente a quien decida ignorarlas. Tampoco sustituyen una contraseña, un sistema de permisos o una configuración de servidor.
Por tanto, si una página contiene información privada, no basta con incluir su ruta en Disallow. La URL y el contenido podrían seguir siendo accesibles si no existe una protección real. Para restringir información se necesita autenticación o una medida de seguridad equivalente.
RFC 9309: especificación del Robots Exclusion Protocol.
La nueva señal: una preferencia común en lugar de muchas reglas
El borrador publicado el 30 de octubre propone utilizar un identificador común en la línea User-agent de robots.txt: __usage_ai-training. De este modo, el administrador podría expresar una preferencia sobre el entrenamiento de IA sin tener que repetir la misma regla para cada rastreador comercial. Microsoft incluye en su anuncio un ejemplo de rechazo general:
User-Agent: __usage_ai-training
Disallow: /
También muestra cómo aplicar una restricción a una ruta concreta, en lugar de a todo el sitio. En términos sencillos, el grupo identifica el propósito —entrenamiento de IA— y las reglas indican qué partes del sitio quedan incluidas en esa preferencia.
La propuesta intenta mantenerse cerca de la sintaxis conocida de robots.txt. El borrador de Kevin Kelley explica que no introduce nuevos nombres de directivas ni cambia la gramática básica del protocolo: utiliza un token de política específico en la línea de agente de usuario. Esa decisión busca facilitar la adopción y reducir incompatibilidades con sistemas existentes.
Hay que subrayar el estado del documento. Se trata de un Internet-Draft, es decir, un borrador técnico abierto a revisión, comentarios y cambios. Que figure en el Datatracker de la IETF no significa que ya sea un RFC aprobado ni que todos los proveedores lo interpreten de manera idéntica. La estandarización requiere discusión y consenso; el texto puede evolucionar.
Borrador IETF: Machine-Readable Training Preference Signal.
Entrenar un modelo no es lo mismo que mostrar una página en una respuesta
Una de las confusiones más importantes está en pensar que cualquier uso de una web por parte de una IA es equivalente. En realidad, hay varios procesos que conviene distinguir.
Entrenamiento
El entrenamiento utiliza grandes conjuntos de datos para ajustar los parámetros de un modelo. El contenido puede formar parte de un corpus empleado durante una fase de aprendizaje o mejora. Una preferencia de exclusión de entrenamiento busca comunicar que el editor no desea que sus páginas se utilicen con ese propósito.
Recuperación y fundamentación
En un sistema de recuperación, el modelo o el servicio consulta fuentes externas para responder a una pregunta. La página se recupera en ese momento o dentro de un índice y puede servir como evidencia para elaborar una respuesta. No significa necesariamente que el contenido se incorpore al entrenamiento del modelo.
Rastreo e indexación para buscadores
Los buscadores rastrean páginas para descubrirlas, analizarlas e incorporarlas a sus índices. Algunos servicios combinan ese índice con respuestas generadas por IA. Por eso una instrucción que limite el entrenamiento no equivale automáticamente a impedir el rastreo de búsqueda, ni a retirar una URL del índice.
Google explica expresamente que Google-Extended es un control independiente y que no afecta a la inclusión en la Búsqueda de Google. Su documentación también diferencia las reglas para Googlebot, que afectan al rastreo de búsqueda, de los controles para otros usos de IA. Microsoft, por su parte, separa en su propuesta las preferencias de entrenamiento y las de grounding.
La consecuencia práctica es que no existe un único interruptor universal para todos los usos. Antes de bloquear algo, el propietario debe decidir qué quiere limitar: el entrenamiento, la recuperación en respuestas, la aparición en buscadores o una combinación de estos procesos. Cada decisión puede tener efectos distintos sobre la visibilidad y el tráfico.
Qué implica para el SEO y la visibilidad de una web
La señal compartida puede simplificar la gestión técnica, pero no es una estrategia SEO ni una garantía de visibilidad. Su función es comunicar una preferencia de uso a los proveedores que decidan reconocerla. No mejora por sí misma el posicionamiento, no consigue que una página sea citada por un asistente y tampoco sustituye el trabajo editorial.
El punto delicado es la relación entre control y descubrimiento. Un propietario puede querer evitar que sus textos se utilicen para entrenar modelos y, al mismo tiempo, desear que sus páginas aparezcan en buscadores o que se consulten como fuente en respuestas de IA. Esa combinación exige controles diferenciados y una lectura cuidadosa de la documentación de cada servicio.
En Google, por ejemplo, bloquear el rastreo de Googlebot con robots.txt puede afectar a la forma en que la Búsqueda accede a una página. La compañía explica que Google-Extended no altera la inclusión en sus resultados. Por tanto, no conviene sustituir una regla por otra sin entender qué agente y qué producto controla cada una.
En Bing, Microsoft afirma que sus preferencias de entrenamiento y grounding no modificarán la elegibilidad para los resultados de Bing. Sin embargo, restringir el grounding sí puede reducir la presencia del contenido en determinadas experiencias generativas. Es un intercambio que cada editor deberá valorar según sus objetivos.
Para profundizar en cómo preparar contenidos para buscadores y respuestas generativas, puedes consultar esta guía del blog: SEO, AEO y GEO: cómo ganar visibilidad en buscadores y respuestas de IA. La nueva señal aborda el control de uso; la calidad, la claridad y la utilidad del contenido siguen siendo cuestiones distintas.
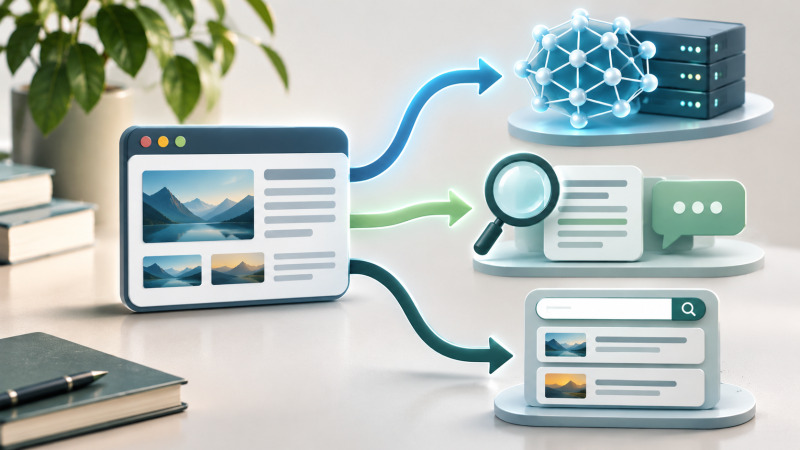
Una misma página puede intervenir en procesos distintos, que no se controlan necesariamente con la misma regla.
Qué deberían hacer ahora los propietarios de webs y WordPress
La recomendación inmediata no es copiar el ejemplo en producción, sino preparar la web para decidir con conocimiento cuando los controles estén disponibles. En un sitio WordPress, robots.txt suele gestionarse desde el servidor, el hosting, un plugin SEO o una herramienta de administración. La ubicación exacta depende de la instalación: algunas webs sirven un archivo físico y otras generan una respuesta virtual.
1. Localizar el robots.txt actual
Abre la dirección del dominio seguida de /robots.txt y guarda una copia del contenido. Comprueba si existen grupos para Googlebot, Bingbot, Google-Extended u otros rastreadores. No des por hecho que el archivo visible desde el navegador coincide con el que permite editar el plugin o el panel del hosting.
2. Identificar quién lo administra
En WordPress, algunos plugins SEO permiten editar el archivo desde sus herramientas. En otros casos, el hosting o el servidor mantienen un archivo real en la raíz de la instalación. Antes de cambiar nada, averigua qué sistema tiene prioridad y evita mantener dos versiones que puedan confundirse.
3. Definir una política editorial y comercial
La decisión no debería tomarla únicamente quien administra el servidor. Una empresa puede tener contenidos públicos que quiere mantener visibles, documentación técnica que desea excluir del entrenamiento, materiales licenciados con condiciones específicas y páginas de clientes o usuarios que nunca deberían exponerse. Conviene documentar qué usos se permiten y quién tiene autoridad para decidirlo.
4. Esperar a la documentación de implementación
OpenAI todavía habla de los próximos meses; Google apunta a 2027 y Microsoft ya ha publicado ejemplos y un calendario de transición. La sintaxis concreta, la interpretación de excepciones y la compatibilidad de cada rastreador deben revisarse cuando cada proveedor confirme el despliegue. No basta con que una regla parezca válida desde el punto de vista sintáctico.
5. Probar los cambios y conservar un registro
Cuando llegue el momento, realiza primero una prueba controlada. Comprueba que el archivo se sirve con normalidad, que no se han eliminado reglas necesarias y que los rastreadores que deseas mantener pueden acceder a las rutas públicas. Anota la fecha del cambio y revisa los anuncios oficiales para detectar modificaciones en la interpretación.
En una tienda WooCommerce o en una web de servicios, hay que prestar especial atención a las áreas privadas, los resultados de búsqueda internos, las páginas de cuenta y los recursos necesarios para renderizar la web. No deben utilizarse reglas generales sin comprobar antes sus efectos.
Lo que la señal no puede garantizar
La primera limitación es técnica: robots.txt funciona como un conjunto de instrucciones para rastreadores que deciden respetarlo. No impide que un tercero copie manualmente una página, que otro bot ignore las reglas o que un contenido ya recopilado siga formando parte de un conjunto de datos anterior. La propia RFC 9309 advierte que el protocolo no es una forma de autorización de acceso.
La segunda limitación es temporal. Un cambio publicado hoy no puede borrar automáticamente copias que un proveedor haya obtenido ayer ni modificar de forma retroactiva el uso de datos ya procesados. El borrador de AIPREF explica que los rastreadores consultan una versión del archivo y aplican las preferencias cuando vuelven a recuperar los recursos afectados. El comportamiento real dependerá de las políticas y los procesos de cada servicio.
La tercera limitación es la adopción. La iniciativa necesita que los proveedores implementen el mecanismo, que lo documenten y que mantengan una interpretación compatible. Un estándar común puede reducir la fragmentación, pero no elimina de golpe las diferencias entre plataformas. Tampoco obliga por sí solo a un servicio que no participa.
Por último, una preferencia técnica no resuelve todas las cuestiones jurídicas sobre derechos de autor, licencias, bases legales o excepciones aplicables. Puede servir como señal legible por máquinas y como evidencia de la voluntad del editor, pero no sustituye asesoramiento jurídico ni un contrato de licencia cuando el uso del contenido lo requiere.
Antes de aplicar nuevas reglas conviene identificar quién administra el archivo y qué rastreadores deben seguir accediendo.
Una oportunidad para ordenar las reglas, no para olvidarse de ellas
El valor de esta iniciativa está en algo bastante concreto: si los principales proveedores adoptan una señal compartida, los propietarios de webs podrán expresar una misma preferencia sin mantener tantas reglas duplicadas. Para medios, blogs, comercios y empresas con grandes bibliotecas de contenido, esa simplificación puede reducir errores y facilitar una política coherente.
Pero la decisión seguirá siendo estratégica. No todos los sitios querrán bloquear el mismo uso, y entrenamiento, grounding y búsqueda no son sinónimos. Algunos editores pueden priorizar la visibilidad en respuestas generativas; otros pueden preferir limitar ciertos usos y conservar la presencia en buscadores. La señal común no decide por ellos: les ofrece una forma más sencilla de comunicar parte de esa decisión.
En noviembre de 2026, lo sensato es revisar el robots.txt existente, identificar los controles específicos que ya están activos y seguir la documentación oficial de cada proveedor. Cuando la implementación esté confirmada, habrá que valorar el cambio en un entorno controlado y comprobar que no afecta al rastreo que sí interesa mantener.
En una web profesional, la gestión de rastreadores forma parte de una arquitectura más amplia: contenidos bien estructurados, permisos correctos, rendimiento, accesibilidad y una estrategia clara de visibilidad. Si necesitas revisar la estructura técnica o editorial de tu sitio, en Joan Alonso Design trabajo en diseño y desarrollo web con WordPress, cuidando tanto la presentación como la gestión de los contenidos.
Preguntas frecuentes
¿Puedo añadir ya __usage_ai-training a mi robots.txt?
El token aparece en un borrador técnico y Microsoft ya publica ejemplos, pero la compatibilidad no está desplegada de forma uniforme. Antes de aplicarlo, revisa la documentación vigente de los proveedores que te interesan y confirma que reconocen esa sintaxis. No lo trates todavía como un control universal.
¿Bloquear el entrenamiento hará que mi web desaparezca de Google?
No necesariamente. Google afirma que Google-Extended no afecta a la inclusión en la Búsqueda. Sin embargo, bloquear Googlebot con reglas generales sí puede afectar al rastreo de búsqueda. Son controles distintos y deben configurarse por separado.
¿La señal impide que una IA cite mis artículos?
No por sí sola. La propuesta descrita se centra en las preferencias de entrenamiento. La recuperación de páginas para fundamentar respuestas es otro uso, que algunos proveedores gestionan mediante controles separados. Microsoft, por ejemplo, distingue expresamente entrenamiento y grounding.
¿robots.txt protege mis contenidos frente a cualquier bot?
No. Es un protocolo de instrucciones para rastreadores conformes, no un sistema de autenticación ni una barrera de seguridad. Para proteger contenido privado hay que restringir el acceso desde el servidor o mediante un sistema de permisos.
¿Tengo que instalar un plugin en WordPress?
No necesariamente. robots.txt puede gestionarse desde el hosting, desde un archivo físico o mediante herramientas de WordPress. Lo importante es saber qué sistema sirve el archivo real y hacer cambios después de revisar la documentación oficial.